Gradient Boosting: Giải Mã Thuật Toán Mạnh Mẽ trong Học Máy
Gradient Boosting là một thuật toán mạnh mẽ không thể bỏ qua trong các bài toán xử lý dữ liệu dạng bảng. Với khả năng khám phá các quan hệ phi tuyến phức tạp, nó hoàn toàn giải quyết được các vấn đề phổ biến trong các kiểu dữ liệu dạng bảng như giá trị thiếu, ngoại lai hay dữ liệu phân loại có nhiều giá trị.
Bài viết này sẽ cung cấp cho bạn cái nhìn sâu sắc về Gradient Boosting, giúp bạn không chỉ biết cách sử dụng mà còn hiểu được tại sao nó lại hiệu quả đến vậy. Khi đã nắm vững nguyên lý, bạn sẽ có đủ kiến thức để tinh chỉnh siêu tham số, tùy chỉnh hàm lỗi, từ đó nâng cao đáng kể chất lượng mô hình của mình.
1. Giới thiệu
Nhắc lại một chút về thuật toán Boosting
Để hiểu về Gradient Boosting, trước hết chúng ta cần nắm vững khái niệm Boosting. Boosting là một kỹ thuật học kết hợp (ensemble learning) nhằm cải thiện hiệu suất của các mô hình học máy.
Ý tưởng chính của Boosting là xây dựng một mô hình mạnh (strong learner) bằng cách kết hợp nhiều mô hình yếu (weak learners) một cách tuần tự. Mỗi mô hình yếu được thêm vào sẽ tập trung vào việc sửa chữa lỗi của các mô hình trước đó.
Hãy tưởng tượng bạn đang cố gắng giải một bài toán cực kỳ khó. Thay vì cố gắng giải nó một mình, bạn nhờ một nhóm bạn cùng giúp sức. Mỗi người bạn sẽ giải một phần của bài toán. Tuy nhiên, họ không giải độc lập mà người sau sẽ dựa vào kết quả của người trước để sửa lỗi và hoàn thiện. Cứ như vậy, qua nhiều vòng, cả nhóm sẽ tìm ra được lời giải chính xác nhất.
Gradient Boosting
Gradient Boosting là một loại thuật toán Boosting, nhưng nó sử dụng một cách tiếp cận đặc biệt để sửa lỗi. Thay vì chỉ đơn thuần cộng thêm các mô hình yếu (weak learners), Gradient Boosting sử dụng Gradient Descent để tối ưu hóa hàm mất mát (loss function).
Gradient Descent là một thuật toán tối ưu hóa quen thuộc, dùng để tìm giá trị nhỏ nhất của một hàm số. Trong Gradient Boosting, chúng ta sẽ sử dụng nó để tìm "hướng đi" tốt nhất cho mô hình tiếp theo, sao cho nó có thể giảm thiểu lỗi của mô hình hiện tại một cách hiệu quả nhất. Về mặt lý thuyết, gradient boosting có thể được xem như một dạng gradient descent (xuống dốc theo đạo hàm) trong không gian hàm (functional gradient descent), khi mỗi bước mở rộng (boosting step) thực hiện một “bước” nhỏ hướng tới giảm thiểu hàm mất mát (loss function).

2. Cách thức hoạt động của Gradient Boosting
Cho tập huấn luyện , hàm mất mát và số vòng lặp (số cây) . Gradient Boosting xây dựng mô hình theo các bước sau:Bước 1: Khởi tạo mô hình ban đầu sao cho tối thiểu hóa hàm mất mát trên toàn bộ dữ liệu.
Bước 2: Lặp từ :
- Tính "phần dư" (Residuals):
- Huấn luyện mô hình mới: Tìm đạo hàm âm của hàm mất mát tại dự đoán hiện tại
- Tìm hệ số bước :
- Cập nhật mô hình:
Bước 3: Sau vòng lặp, kết quả dự đoán chính là kết quả đầu ra của mô hình cuối cùng
Chắc hẳn khi nhìn vào các công thức trên, sẽ có nhiều bạn cảm thấy khó hiểu. Để cho dễ hình dung, mình sẽ sử dụng một ví dụ minh hoạ đơn giản và thực hiện lại các bước tính toán của thuật toán nhé!
Cho tập dữ liệu thể hiện giá của một căn nhà dựa vào diện tích như sau:
| Diện tích (x) | Giá nhà (y) |
|---|---|
| 100 | 1.5 |
| 120 | 1.8 |
| 150 | 2.5 |
| 180 | 2.0 |
| 200 | 2.2 |
Khởi tạo mô hình
Chúng ta khởi tạo mô hình ban đầu bằng cách lấy giá trị trung bình của tất cả các giá nhà trong tập dữ liệu.Tính "phần dư" (Residuals)
Residuals là lỗi của mô hình hiện tại. Nó được tính bằng cách lấy giá trị thực trừ đi giá trị dự đoán .Lúc này, từ bảng dữ liệu huấn luyện ban đầu ta có:
| Diện tích (x) | Giá nhà (y) | Dự đoán | Residuals |
|---|---|---|---|
| 100 | 1.5 | 2.0 | -0.5 |
| 120 | 1.8 | 2.0 | -0.2 |
| 150 | 2.5 | 2.0 | 0.5 |
| 180 | 2.0 | 2.0 | 0.0 |
| 200 | 2.2 | 2.0 | 0.2 |
Huấn luyện và cập nhập mô hình
Chúng ta huấn luyện một cây quyết định mới trên tập dữ liệu với giá trị residuals là mục tiêu. Cây quyết định này sẽ học cách dự đoán lỗi của mô hình trước đó. Giả sử sau huấn luyện ta thu được một weak-learner có root là , ta có thể tính được hệ số bước cho mỗi node lá như sau:| Diện tích (x) | Dự đoán Residual |
|---|---|
| 100 | -0.35 |
| 120 | -0.35 |
| 150 | 0.233 |
| 180 | 0.233 |
| 200 | 0.233 |
Sau khi cập nhập mô hình ta có:
| Diện tích (x) | Giá nhà (y) | Dự đoán | Dự đoán |
|---|---|---|---|
| 100 | 1.5 | 2.0 | 1.895 |
| 120 | 1.8 | 2.0 | 1.895 |
| 150 | 2.5 | 2.0 | 2.0699 |
| 180 | 2.0 | 2.0 | 2.0699 |
| 200 | 2.2 | 2.0 | 2.0699 |
Nhận xét: Các giá trị dự đoán của mô hình đã gần hơn so với giá trị thực . Quá trình này sẽ được lặp lại lần (tương ướng với cây)Qua ví dụ trên các bạn chắc hẳn cũng đã phần nào hiểu hơn về cơ chế hoạt động của thuật toán Gradient Boosting. Nhưng các bạn có thắc mắc tại sao giá trị khởi tạo mô hình lại là giá trị trung bình của tập đầu vào hay các giá trị dự đoán ở cây kế tiếp lại là giá trị trung bình của residual hay không ? Chúng ta sẽ cùng nhau trả lời những câu hỏi trên nhé!
Mean Squared Error (MSE)
MSE là một hàm mất mát phổ biến cho bài toán hồi quy, có dạng:Chúng ta tạm thời không quan tâm đến giá trị 2 trong hàm trên vì đây là một hằng số, mục tiêu của chúng ta là sẽ tối thiểu hoá hàm mất mát này để sai số giữa giá trị dự đoán và gia trị thực là nhỏ nhất. Chính vì vậy, để tìm cực tiểu của một hàm số, ta cần đi theo hướng ngược lại của đạo hàm.
Sử dụng MSE ta có:
Để tìm giá trị tối ưu ta cho đạo hàm bằng 0:
3. Gradient Boosting cho bài toán Phân loại
Trong bài toán phân loại, ý tưởng cốt lõi của Gradient Boosting vẫn tương tự như trong hồi quy: xây dựng mô hình mạnh từ các mô hình yếu một cách tuần tự, tập trung vào việc sửa chữa lỗi của các mô hình trước đó. Tuy nhiên, có một vài thay đổi quan trọng:
- Hàm mất mát: Chúng ta không sử dụng MSE nữa. Thay vào đó, chúng ta sẽ sử dụng các hàm mất mát phù hợp với bài toán phân loại, chẳng hạn như Binary Cross-Entropy (đối với bài toán phân loại nhị phân) hoặc Categorical Cross-Entropy (đối với bài toán đa lớp).
- Residual (Phần dư): Thay vì residual trực tiếp, chúng ta sẽ sử dụng pseudo-residual, là gradient âm của hàm mất mát. Cây quyết định mới sẽ học cách dự đoán các giá trị này.
- Dự đoán: Mô hình sẽ dự đoán log-odds hoặc xác suất, thay vì giá trị thực. Sau đó, chúng ta sẽ sử dụng các hàm chuyển đổi như Sigmoid hoặc Softmax để biến đổi thành xác suất cuối cùng.
Tương tụ như bài toán hồi quy, mình cũng sẽ sử dụng một ví dụ minh hoạ đơn giản và thực hiện lại các bước tính toán của thuật toán để có thể dễ dàng hình dung nhất nhé!
Giả sử chúng ta cần dự đoán một khách hàng có mua sản phẩm hay không (có = 1, không = 0) dựa trên số lần truy cập website.
| Số lần truy cập (x) | Mua hàng (y) |
|---|---|
| 10 | 1 |
| 15 | 0 |
| 20 | 1 |
| 25 | 0 |
| 30 | 1 |
Khởi tạo mô hình cho bài toán
Chúng ta khởi tạo mô hình ban đầu bằng cách lấy giá trị log-odds. Với là xác suất của lớp 1 (khách hàng mua hàng). Trong ví dụ này, có 3 người mua hàng trong tổng số 5 người, nênĐây là giá trị dự đoán ban đầu của chúng ta trên thang log-odds.
Tính toán Pseudo-Residual
Vì đây là bài toán phân loại nhị phân nền chúng ta sẽ sử dụng Binary Cross-Entropy làm hàm mất mát, có dạng:
Lúc này, ta có bảng dữ liệu sau:
| Số lần truy cập (x) | Mua hàng (y) | Dự đoán log-odds | Dự đoán xác suất | Pseudo-Residual |
|---|---|---|---|---|
| 10 | 1 | 0.405 | 0.6 | 0.4 |
| 15 | 0 | 0.405 | 0.6 | -0.6 |
| 20 | 1 | 0.405 | 0.6 | 0.4 |
| 25 | 0 | 0.405 | 0.6 | -0.6 |
| 30 | 1 | 0.405 | 0.6 | 0.4 |
Các giá trị pseudo-residual này chính là "mục tiêu" mới mà cây quyết định tiếp theo cần học.
Huấn luyện và cập nhập
Tương tự như bài toán hồi quy, chúng ta huấn luyện một cây quyết định mới trên tập dữ liệu với giá trị pseudo-residual là mục tiêu. Giả sử sau huấn luyện ta thu được một weak-learner có root là , ta có thể tính được hệ số bước cho mỗi node lá như sau:| Số lần truy cập (x) | Dự đoán pseudo-residual |
|---|---|
| 10 | -0.417 |
| 15 | -0.417 |
| 20 | 0.278 |
| 25 | 0.278 |
| 30 | 0.278 |
Cập nhập tương tự cho toàn bộ tập dữ liệu, ta có:
| Số lần truy cập (x) | Mua hàng (y) | Dự đoán | Hệ số bước | Cập nhật | Dự đoán xác suất |
|---|---|---|---|---|---|
| 10 | 1 | 0.405 | -0.417 | 0.28 | 0.57 |
| 15 | 0 | 0.405 | -0.417 | 0.28 | 0.57 |
| 20 | 1 | 0.405 | 0.278 | 0.49 | 0.62 |
| 25 | 0 | 0.405 | 0.278 | 0.49 | 0.62 |
| 30 | 1 | 0.405 | 0.278 | 0.49 | 0.62 |
Nhận xét: Các giá trị xác suất đã thay đổi. Mô hình đã được cập nhật và trở nên chính xác hơn.
4. Code Implementation
Vừa rồi, chúng ta đã tìm hiểu về thuật toán Gradient Boosting và có thể thấy rằng quá trình tính toán của nó khá phức tạp — từ việc xây dựng một weak learner cho đến giai đoạn huấn luyện và cập nhật mô hình liên tục. Tuy nhiên, khi triển khai bằng code thì mọi thứ lại trở nên đơn giản hơn rất nhiều, bởi các thư viện như scikit-learn đã hỗ trợ sẵn. Nhờ vậy, bạn hoàn toàn có thể xây dựng một mô hình Gradient Boosting chỉ với một dòng lệnh.
Chuẩn bị dữ liệu
Chúng ta sẽ sử dụng bộ dữ liệu "Housing" làm tập dữ liệu huấn luyện cho Gradient Boost. Bộ dữ liệu cung cấp thông tin chi tiết về các đặc điểm của các ngôi nhà. Mục đích chính của tập dữ liệu này có thể là để phân tích mối quan hệ giữa các đặc điểm này và giá nhà, giúp dự đoán giá trị bất động sản dựa trên các yếu tố như diện tích, số phòng ngủ và các tiện ích khác.
Các bạn có thể tải dữ liệu tại đây
Đầu tiên, chúng ta import các thư viện cần thiết.
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.ensemble import RandomForestRegressor, AdaBoostRegressor, GradientBoostingRegressor
from sklearn.preprocessing import OrdinalEncoder
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error, mean_squared_error
from ydata_profiling import ProfileReport
Bây giờ chúng ta đã có dữ liệu, chúng ta cần kiểm tra và đánh giá bộ dữ liệu.
dataset_path = './Housing.csv'
df = pd.read_csv(dataset_path)
df
df.info()
| # | Column | Non-Null Count | Dtype |
|---|---|---|---|
| 0 | price | 545 non-null | int64 |
| 1 | area | 545 non-null | int64 |
| 2 | bedrooms | 545 non-null | int64 |
| 3 | bathrooms | 545 non-null | int64 |
| 4 | stories | 545 non-null | int64 |
| 5 | mainroad | 545 non-null | object |
| 6 | guestroom | 545 non-null | object |
| 7 | basement | 545 non-null | object |
| 8 | hotwaterheating | 545 non-null | object |
| 9 | airconditioning | 545 non-null | object |
| 10 | parking | 545 non-null | int64 |
| 11 | prefarea | 545 non-null | object |
| 12 | furnishingstatus | 545 non-null | object |
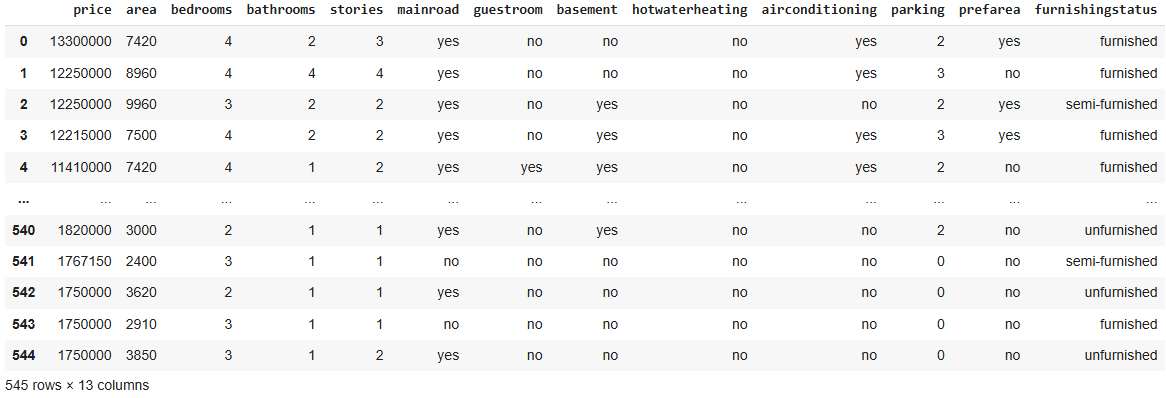
Bộ dữ liệu gồm 545 mẫu với 13 thuộc tính, trong đó biến mục tiêu là price và các đặc trưng còn lại đóng vai trò biến độc lập. Chúng ta có thể liệt kê số lượng giá trị phân loại (categories) trong từng cột dạng categorical (object) của DataFrame để lựa chọn chiến lược tiền xử lý phù hợp
categorical_cols = df.select_dtypes(include=['object']).columns.to_list()
for col_name in categorical_cols:
    n_categories = df[col_name].nunique()
    print(f'Number of categories in {col_name}: {n_categories}')

# Number of categories in mainroad: 2
# Number of categories in guestroom: 2
# Number of categories in basement: 2
# Number of categories in hotwaterheating: 2
# Number of categories in airconditioning: 2
# Number of categories in prefarea: 2
# Number of categories in furnishingstatus: 3
Tiền xử lý dữ liệu
Chúng ta cần chuyển toàn bộ các biến rời rạc về dạng dữ liệu mà mô hình học máy có thể xử lý được. OrdinalEncoder giúp gán mỗi nhãn phân loại một giá trị số nguyên.
categorical_cols = df.select_dtypes(include=['object']).columns.to_list()

ordinal_encoder = OrdinalEncoder()
encoded_categorical_cols = ordinal_encoder.fit_transform(
    df[categorical_cols]
)
encoded_categorical_df = pd.DataFrame(
    encoded_categorical_cols,
    columns=categorical_cols
)
numerical_df = df.drop(categorical_cols, axis=1)
encoded_df = pd.concat(
    [numerical_df, encoded_categorical_df], axis=1
)
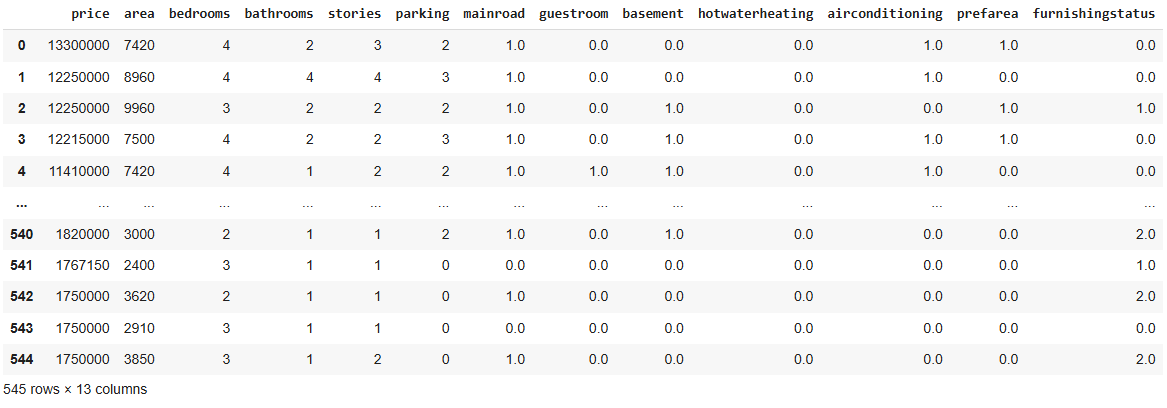
Do các biến số có khoảng giá trị khác nhau (ví dụ: area rất lớn so với parking) nên ta cần chuẩn hóa dữ liệu
normalizer = StandardScaler()
dataset_arr = normalizer.fit_transform(encoded_df)

# array([[ 4.56636513,  1.04672629,  1.40341936, ...,  1.4726183 ,
#          1.80494113, -1.40628573],
#        [ 4.00448405,  1.75700953,  1.40341936, ...,  1.4726183 ,
#         -0.55403469, -1.40628573],
#        [ 4.00448405,  2.21823241,  0.04727831, ..., -0.67906259,
#          1.80494113, -0.09166185],
#        ...,
#        [-1.61432675, -0.70592066, -1.30886273, ..., -0.67906259,
#         -0.55403469,  1.22296203],
#        [-1.61432675, -1.03338891,  0.04727831, ..., -0.67906259,
#         -0.55403469, -1.40628573],
#        [-1.61432675, -0.5998394 ,  0.04727831, ..., -0.67906259,
#         -0.55403469,  1.22296203]])
Khởi tạo và huấn luyện mô hình
Sau khi dữ liệu đã được xử lý, chúng ta sẽ chia chúng ra thành các tâp train và test theo tỷ lệ 7:3
X, y = dataset_arr[:, 1:], dataset_arr[:, 0]

test_size = 0.3
random_state = 1
is_shuffle = True
X_train, X_val, y_train, y_val = train_test_split(
    X, y, test_size=test_size, random_state=random_state, shuffle=is_shuffle
)
Chúng ta sẽ khởi tạo mô hình Gradient Boosting Regressor. Ở đây, tham số random_state được truyền vào để đảm bảo kết quả tái lập, còn learning_rate=0.1 kiểm soát tốc độ học, tức là mức độ mà mỗi cây mới đóng góp vào mô hình tổng thể. Sau khi khởi tạo, mô hình được huấn luyện bằng cách gọi fit(X_train, y_train).
regressor = GradientBoostingRegressor(
    random_state=random_state, learning_rate=0.1
)
regressor.fit(X_train, y_train)
Đánh giá trên tập test
mae = mean_absolute_error(y_val, y_pred)
mse = mean_squared_error(y_val, y_pred)

print('Evaluation results on validation set:')
print(f'Mean Absolute Error: {mae}')
print(f'Mean Squared Error: {mse}')

# Evaluation results on validation set:
# Mean Absolute Error: 0.4516626127750995
# Mean Squared Error: 0.39610445936979427
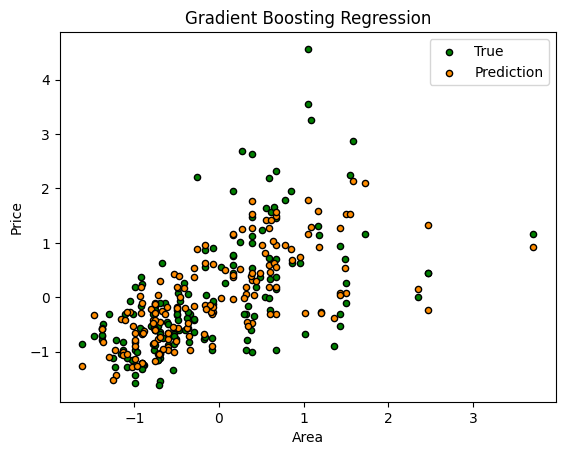
Nhận xét: Kết quả đánh giá cho mô hình trên tập test cho thấy mô hình dự đoán khá tốt, sai số trung bình nhỏ