Chẩn đoán bệnh tim mạch với Ensemble Learning
I. Giới thiệu
Bệnh tim mạch (Cardiovascular Disease – CVD) là nguyên nhân hàng đầu gây tử vong trên toàn cầu. Theo WHO, năm 2019 có khoảng 17,9 triệu ca tử vong do CVD, chiếm 32% tổng số tử vong toàn cầu, và con số này dự báo sẽ tăng lên 23 triệu vào năm 2030. Việc phát hiện sớm bệnh tim mạch là then chốt để can thiệp kịp thời và giảm thiểu tử vong và tối ưu hóa chi phí chăm sóc sức khỏe. Các phương pháp học máy đã được xem là công cụ triển vọng trong việc chẩn đoán sớm và chính xác bệnh tim mạch.
Các phương pháp học tập hợp (ensemble learning) — bằng cách kết hợp nhiều bộ phân lớp cơ sở — đã chứng tỏ khả năng bắt được các quan hệ phi tuyến, giảm phương sai/độ lệch, và nâng cao khả năng tổng quát hóa so với mô hình đơn lẻ như Random Forest, Boosting. Trong bối cảnh dữ liệu y tế, những ưu điểm này rất phù hợp: ensemble mô hình có thể xử lý tương tác phức tạp giữa biến, giảm overfitting khi số mẫu hạn chế, và cung cấp các chỉ báo quan trọng về tính đóng góp của từng đặc trưng. Bên cạnh kiến trúc mô hình, xử lý dữ liệu trước khi huấn luyện — bao gồm feature engineering (FE) và lựa chọn đặc trưng dựa trên cây quyết định (decision tree-based feature selection) — đóng vai trò then chốt nhằm tách lọc thông tin hữu ích và loại bỏ nhiễu, từ đó tăng tính ổn định và hiệu năng cho mô hình phân loại.
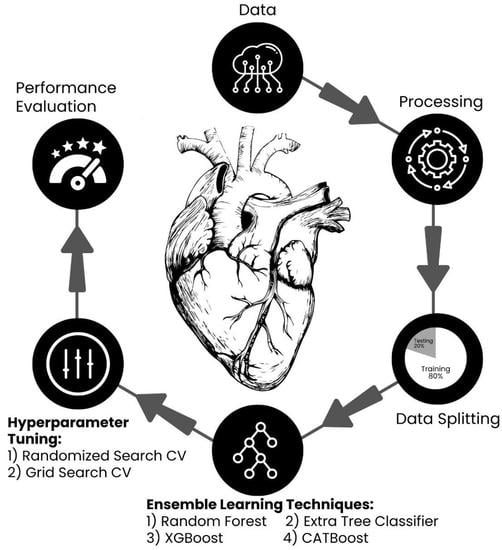
Nhiều nghiên cứu về chẩn đoán bệnh tim tận dụng cả hai chiều phát triển hoặc tinh chỉnh thuật toán phân loại và xử lý dữ liệu trước khi huấn luyện. Thuật toán mạnh nhưng dữ liệu nhiễu và cân bằng kém vẫn cho kết quả tệ, trong khi dữ liệu đã được xử lý tốt có thể khiến các mô hình đơn giản cũng hoạt động tốt hơn.
Trong bài viết này, nhóm sẽ thực hiện chẩn đoán bệnh tim trên tập dữ liệu UCI Heart Disease bằng cách kết hợp các thuật toán ensemble và các chiến lược dữ liệu nhằm xử lý đặc trưng và cân bằng tập huấn luyện. Cụ thể, nhóm áp dụng và so sánh nhiều phương pháp ensemble phổ biến — bao gồm Random Forest, AdaBoost, Gradient Boosting, XGBoost và CatBoost — trên bốn phiên bản dữ liệu:
- Bộ gốc.
- Bộ đã qua feature engineering (FE).
- Bộ gốc sau khi chọn K = 10 đặc trưng quan trọng bởi Decision Tree (DT).
- Bộ FE sau khi chọn K = 10 đặc trưng bởi DT.
- Bộ FE sau khi thực hiện SMOTE.
Đặc biệt, nhóm áp dụng SMOTE (Synthetic Minority Over-sampling Technique) để khắc phục vấn đề lớp không cân bằng, giúp mô hình không bị thiên lệch sang lớp nhiều mẫu. Nhóm cũng huấn luyện bộ dữ liệu trên CatBoost và LightGMB là hai thuật toán Boosting mới hơn để có góc nhìn tổng quát về hiệu quả của các thuật toán ensemble trên tập dữ liệu UCI Heart Disease.
II. Sơ lược về Ensemble Learning
1. Random Forest
Random Forest nổi bật với cách tiếp cận xây dựng một mô hình dựa trên nhiều cây quyết định (Decision Tree) được tạo ra trong quá trình huấn luyện. Mục đích chủ yếu của thuật toán này là nâng cao hiệu suất dự đoán và khắc phục điểm yếu cố hữu của một cây quyết định riêng lẻ: khả năng bị quá khớp (overfitting) và phương sai lớn.
Để đảm bảo sự đa dạng và giảm thiểu mối tương quan giữa các cây trong "rừng," Random Forest triển khai hai chiến lược ngẫu nhiên hóa chính:
- Kỹ thuật Bagging (Bootstrap Aggregating): Mỗi cây riêng lẻ được đào tạo trên một tập mẫu con khác nhau của dữ liệu huấn luyện. Tập mẫu con này được tạo ra thông qua việc lấy mẫu ngẫu nhiên có hoàn lại (bootstrap) từ bộ dữ liệu gốc.
- Ngẫu nhiên hóa đặc trưng (Feature Randomness): Tại mỗi nút của cây khi tìm điểm chia tốt nhất, thuật toán không đánh giá tất cả các đặc trưng sẵn có mà chỉ giới hạn việc tìm kiếm trong một tập hợp con ngẫu nhiên của các đặc trưng đó.
Khi cần đưa ra dự đoán cho dữ liệu mới, kết quả cuối cùng sẽ là sự kết hợp của tất cả các cây thành phần. Cụ thể, trong bài toán phân loại, mô hình sử dụng quy tắc bầu cử đa số (majority voting) để chọn ra lớp được dự đoán nhiều nhất. Đối với bài toán hồi quy, mô hình sẽ tính giá trị trung bình của các dự đoán từ các cây. Nhờ sự tổng hợp từ nhiều mô hình con đa dạng, Random Forest tạo nên một mô hình mạnh mẽ, có độ chính xác cao và khả năng khái quát hóa vượt trội trên dữ liệu chưa từng được quan sát.

2. AdaBoost
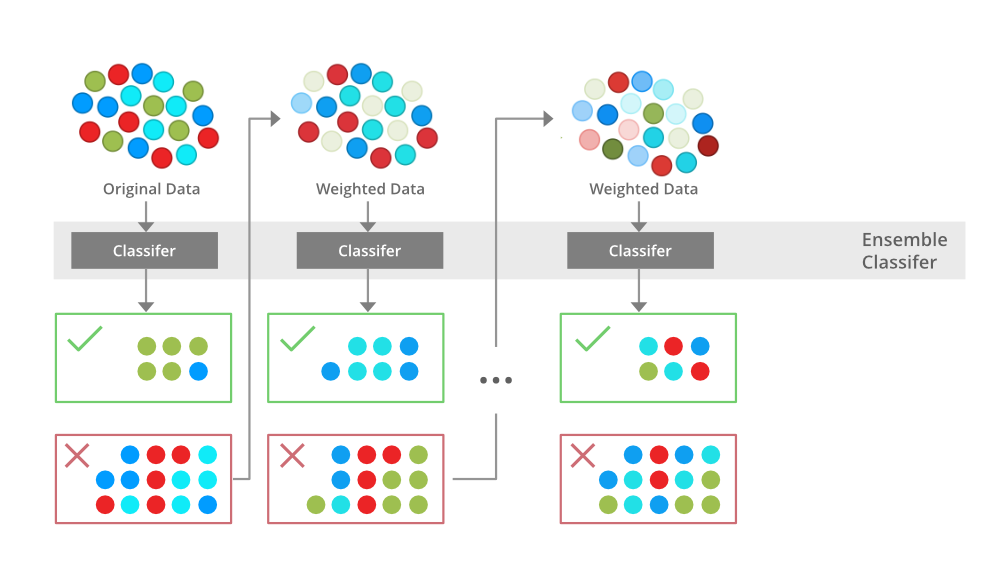
AdaBoost là một thuật toán boosting hoạt động dựa trên một quy trình lặp đi lặp lại, có tính thích nghi cao, nhằm đặt trọng tâm vào những mẫu dữ liệu đã bị các phân loại viên trước đó xử lý sai. Cách thức triển khai chi tiết được tiến hành như sau:
- Khởi tạo: Ban đầu, mỗi mẫu dữ liệu trong bộ huấn luyện được gán trọng số (weight) ngang nhau.
- Xây dựng mô hình yếu đầu tiên: Một bộ học yếu (Weak Learner 1), thường là một cây quyết định đơn giản (ví dụ: một stump), sẽ được đào tạo trên tập dữ liệu này.
- Điều chỉnh trọng số dữ liệu: Sau khi đánh giá hiệu suất của mô hình yếu đầu tiên, thuật toán tiến hành điều chỉnh trọng số của các điểm dữ liệu. Cụ thể, các mẫu bị phân loại sai sẽ được tăng trọng số, trong khi các mẫu được phân loại chính xác sẽ được giảm trọng số. Sự điều chỉnh này có vai trò thúc đẩy mô hình yếu tiếp theo phải chú ý hơn đến các trường hợp khó.
- Lặp lại và tích lũy: Quá trình này được lặp lại với các bộ học yếu mới (Weak Learner 2, Weak Lear 3, v.v.). Mỗi mô hình kế tiếp được huấn luyện trên tập dữ liệu đã điều chỉnh trọng số, do đó, chúng sẽ tập trung vào việc khắc phục những lỗi mà các mô hình tiền nhiệm đã mắc phải.
- Tổng hợp quyết định: Cuối cùng, AdaBoost sẽ kết hợp tất cả các bộ học yếu này để tạo thành một mô hình tổng thể (strong learner). Mỗi bộ học yếu sẽ có một trọng số đóng góp riêng biệt, tỉ lệ thuận với độ chính xác mà nó đạt được. Các mô hình hoạt động hiệu quả hơn sẽ có ảnh hưởng lớn hơn trong việc đưa ra kết quả dự đoán cuối cùng.
Nhờ cơ chế này, AdaBoost tạo ra một mô hình dự đoán mạnh mẽ và có độ chính xác cao, được xây dựng từ sự hợp lực của nhiều mô hình yếu. Mỗi mô hình yếu đều đóng vai trò khắc phục những thiếu sót của mô hình ngay trước nó.
3. Gradient Boosting
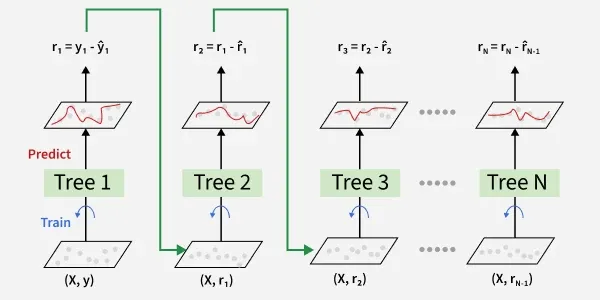
Gradient Boosting khởi đầu bằng một mô hình cơ sở (Init) vô cùng đơn giản, thường là một hằng số hoặc giá trị trung bình của tập dữ liệu. Tiếp theo, thuật toán tiến hành một chu trình lặp đi lặp lại theo các bước sau:
- Xác định phần Dư (Residuals): Trong mỗi vòng lặp, thuật toán tính toán sai số, hay còn gọi là phần dư. Đây là sự chênh lệch giữa giá trị thực tế của dữ liệu với giá trị mà mô hình tổng thể hiện tại đang dự đoán. Phần dư này chính là "lỗi" mà mô hình cần phải tìm cách khắc phục.
- Đào tạo mô hình khắc phục Lỗi: Một bộ học mới, thông thường là một cây quyết định (Learner 1, Learner 2, ...), sẽ được huấn luyện với mục tiêu dự đoán chính xác các phần dư đã tính toán ở bước trên. Thay vì cố gắng dự đoán kết quả cuối cùng, mô hình mới này chỉ tập trung vào việc sửa chữa lỗi của mô hình tổng thể trước đó.
- Cập nhật mô hình tổng thể: Mô hình mới được tạo ra sẽ được tích hợp vào mô hình tổng thể, kèm theo một hệ số học (learning rate) nhỏ. Việc sử dụng hệ số học này có tác dụng kiểm soát tốc độ học tập và giúp ngăn chặn mô hình bị quá khớp (overfitting) một cách nhanh chóng.
Chu trình này sẽ tiếp tục lặp lại cho đến khi đạt được một trong hai điều kiện: mô hình tổng thể chạm đến ngưỡng chính xác được xác định trước, hoặc đã hoàn thành việc xây dựng đủ số lượng cây theo quy định. Sản phẩm cuối cùng là một mô hình tổng hợp vô cùng mạnh mẽ và hiệu quả, được hình thành thông qua sự tổng hòa tuần tự của tất cả các mô hình nhỏ đã được huấn luyện để sửa lỗi.
4. XGBoost
XGBoost (Extreme Gradient Boosting) là một sự phát triển vượt trội từ thuật toán Gradient Boosting, tích hợp nhiều tính năng kỹ thuật nhằm tối ưu hóa hiệu năng và giảm thiểu nguy cơ quá khớp (overfitting). Các đặc điểm nâng cao nổi bật của XGBoost bao gồm:
- Tối ưu hóa tốc độ tính toán: XGBoost sử dụng các phương pháp như Xây dựng Cây Song song (Parallelized Tree Construction) và Tăng tốc bằng GPU (GPU Acceleration). Những kỹ thuật này giúp tăng đáng kể tốc độ xử lý và huấn luyện mô hình, đặc biệt là khi làm việc với các bộ dữ liệu quy mô lớn.
- Xử lý giá trị thiếu hiệu quả: Thuật toán có khả năng tự động xử lý các giá trị bị thiếu (Missing Values). XGBoost tự học được cách đưa ra quy tắc phân nhánh tối ưu nhất ngay cả khi có dữ liệu khuyết thiếu, thay vì phải loại bỏ hoặc điền vào dữ liệu trước.
- Kiểm soát sự phức tạp của mô hình: XGBoost áp dụng các biện pháp Điều chuẩn (Regularization) mạnh mẽ, cụ thể là L1 và L2, để kiểm soát độ phức tạp của các cây quyết định. Điều này giúp ngăn chặn mô hình học quá sát (overfitting) với tập huấn luyện. Ngoài ra, kỹ thuật Cắt tỉa (Pruning) cũng được sử dụng để loại bỏ các nhánh không cần thiết.
Về nguyên lý cốt lõi, XGBoost vẫn giữ cơ chế xây dựng tuần tự một chuỗi các cây quyết định. Mỗi cây mới được tạo ra sẽ có nhiệm vụ khắc phục sai số (lỗi) của các cây đã tồn tại trước đó, qua đó dần dần nâng cao độ chính xác tổng thể của mô hình dự đoán.
5. LightGMB
LightGBM (Light Gradient Boosting Machine) là một biến thể của Gradient Boosting, được phát triển nhằm mục đích giải quyết một số hạn chế cố hữu của các mô hình boosting truyền thống, đặc biệt là về tốc độ huấn luyện và mức tiêu thụ bộ nhớ. Thay vì sử dụng thuật toán tìm kiếm theo chiều ngang (level-wise) để phát triển cây như các GBM tiêu chuẩn (ví dụ như XGBoost), LightGBM áp dụng chiến lược phát triển cây theo chiều sâu (leaf-wise) với độ chính xác cao hơn. Cách tiếp cận này tập trung vào việc mở rộng các nhánh cây mang lại mức giảm lỗi lớn nhất
Cách hoạt động của LightGBM có thể tóm tắt như sau:
- Xây dựng mô hình theo vòng lặp (boosting): Bắt đầu từ một mô hình dự đoán đơn giản, Ở mỗi vòng, LightGBM sẽ xây dựng thêm một cây quyết định để giảm bớt phần lỗi còn lại từ các vòng trước.
- Tăng trưởng cây theo lá (leaf-wise growth): Thay vì chia đều theo từng tầng (level-wise như các thuật toán khác), LightGBM chọn lá có tiềm năng cải thiện lớn nhất để tiếp tục chia nhỏ.
- Sử dụng histogram để tìm điểm chia: LightGBM không xét trực tiếp từng giá trị của dữ liệu mà gom các giá trị vào một số “bin” (thùng). Nhờ vậy, việc tìm điểm chia nhanh hơn nhiều và tốn ít bộ nhớ hơn.
- Tối ưu hóa bằng hai kỹ thuật chính: GOSS (Gradient-based One-Side Sampling) chỉ giữ lại nhiều mẫu có lỗi lớn, còn các mẫu ít quan trọng thì lấy mẫu ngẫu nhiên, giúp tăng tốc độ nhưng vẫn giữ độ chính xác. EFB (Exclusive Feature Bundling) gom các đặc trưng hiếm khi xuất hiện đồng thời thành một đặc trưng duy nhất, giảm số lượng đặc trưng cần xử lý.

6. CatBoost
CatBoost là một biến thể khác của Gradient Boosting nhằm khắc phục các hạn chế cố hữu của các mô hình boosting truyền thống, đặc biệt là sai lệch trong quá trình huấn luyện (prediction shift) và xử lý kém dữ liệu dạng phân loại (categorical features).
Thay vì mã hóa thủ công các biến phân loại như One-Hot hay Label Encoding, CatBoost sử dụng cơ chế target statistics — tức là thay thế các giá trị phân loại bằng các ước lượng dựa trên giá trị mục tiêu, nhưng được tính toán theo một cách ngẫu nhiên có kiểm soát (ordered boosting) để tránh rò rỉ thông tin (data leakage). Cơ chế “ordered boosting” này là điểm nổi bật của CatBoost, giúp giảm đáng kể sai lệch do mô hình “nhìn thấy” thông tin trong tương lai khi đang huấn luyện, từ đó cải thiện khả năng tổng quát hóa.
Bên cạnh đó, CatBoost còn áp dụng nhiều kỹ thuật tối ưu khác như symmetric tree growth (các cây được phát triển đối xứng thay vì tự do như trong XGBoost) giúp quá trình huấn luyện và dự đoán nhanh hơn.

III.Thực nghiệm trên bộ dữ liệu UCI Heart Disease
1. Xử lý dữ liệu
Bộ dữ liệu UCI Heart Disease biểu diễn thông tin lâm sàng của một bệnh nhân với 13 đặc trưng ban đầu, bao gồm cả dạng số và dạng phân loại. Đặc trưng mục tiêu là biến “target”, biểu thị tình trạng bệnh nhân mắc hay không mắc bệnh tim. Một số cột có thể chứa giá trị không hợp lệ hoặc không thể chuyển đổi thành số, do đó nhóm đã chuyển đổi chúng sang định dạng số và thay thế các giá trị không hợp lệ bằng giá trị khuyết (NaN) để xử lý sau. Bên cạnh đó, biến mục tiêu được chuẩn hóa về dạng nhị phân, giúp mô hình hiểu rõ hơn mối quan hệ phân loại giữa hai nhóm “có bệnh” và “không bệnh”.
Các bạn có thể tải dũ liệu gốc tại đây
Nhóm chia dữ liệu thành ba tập riêng biệt: huấn luyện, kiểm định và kiểm tra. Việc chia tập tuân theo tỷ lệ 80–10–10 và có sử dụng chiến lược phân tầng theo biến mục tiêu, đảm bảo rằng tỷ lệ giữa hai nhóm bệnh/không bệnh được giữ nguyên trong mọi tập, tránh tình trạng sai lệch phân bố dữ liệu trong quá trình đánh giá mô hình.
Sau khi chia dữ liệu, nhóm xử lý các đặc trưng bao gồm: đặc trưng số và đặc trưng phân loại.
- Đối với đặc trưng số, các giá trị khuyết được thay thế bằng giá trị trung bình của từng cột. Sau đó, dữ liệu được chuẩn hóa bằng StandardScaler, giúp các giá trị có phân phối chuẩn với trung bình bằng 0 và độ lệch chuẩn bằng 1.
- Với đặc trưng phân loại, giá trị khuyết được điền bằng giá trị xuất hiện thường xuyên nhất. Các biến này tiếp tục được chuẩn hóa bằng MinMaxScaler, nhằm đưa chúng về cùng miền giá trị .
2. Mở rộng dữ liệu
Sau khi hoàn thiện bộ dữ liệu gốc đã qua xử lý, nhóm thực hiện tiếp tục triển khai các bước nâng cao nhằm tối ưu hóa hiệu quả của mô hình học máy. Các bước này tập trung vào việc tăng cường thông tin đặc trưng, lựa chọn những đặc trưng có giá trị cao nhất, và cân bằng lại phân bố dữ liệu giữa các lớp mục tiêu.
Feature Engineering (FE)
Thay vì chỉ sử dụng các biến đo lường trực tiếp, nhóm thực hiện tạo thêm các đặc trưng mới phản ánh mối quan hệ tương đối giữa các thông tin y khoa.
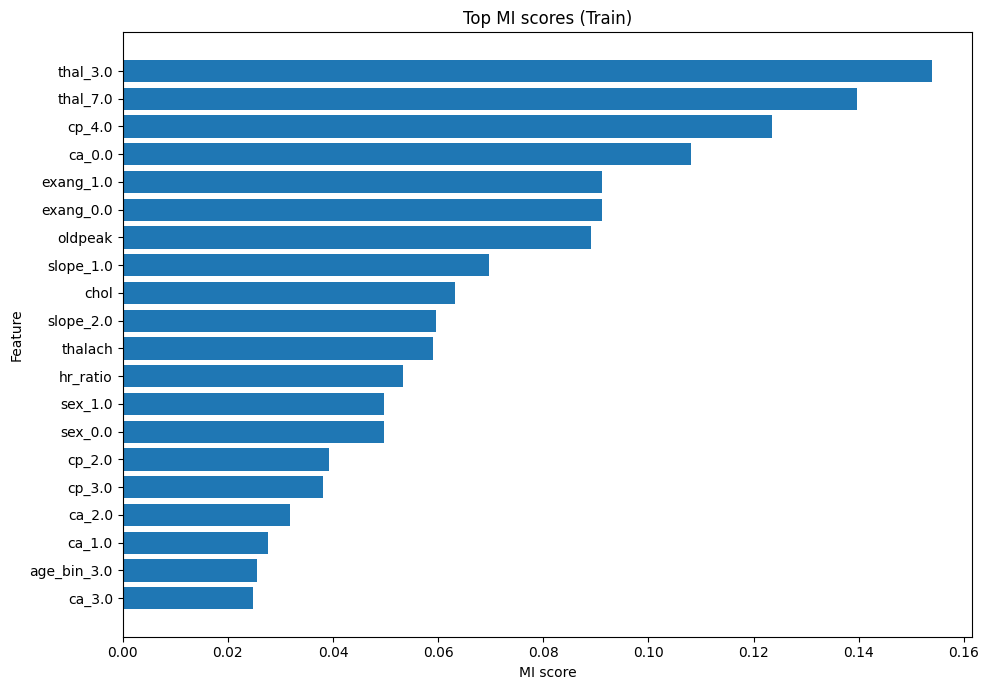
Các đặc trưng được bổ sung có thể bao gồm tỷ lệ giữa các biến số hoặc sự chênh lệch có ý nghĩa lâm sàng. Nhờ đó, mô hình học máy có thể nhận diện được các mẫu phức tạp mà dữ liệu gốc chưa thể hiện rõ. Sau khi tạo ra các đặc trưng mới, nhóm thực hiện tính toán điểm số Mutual Information (MI) cho toàn bộ đặc trưng trong tập FE. Nhóm giữ lại 13 đặc trưng có điểm số MI cao nhất tạo thành một bộ dữ liệu riêng.
Lựa chọn K đặc trưng quan trọng bằng Decision Tree
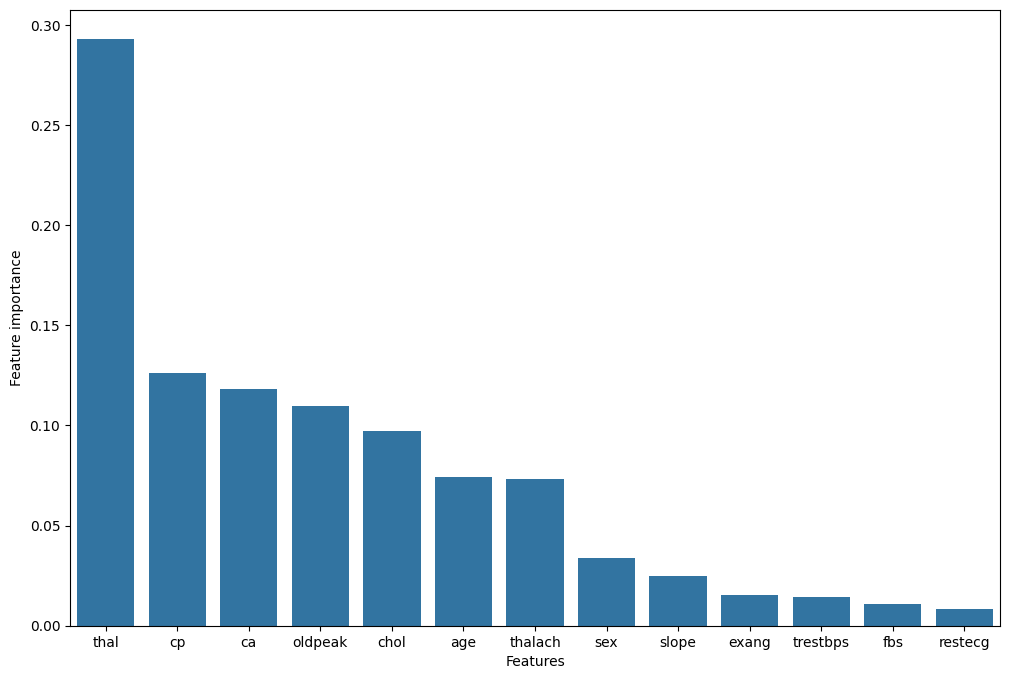
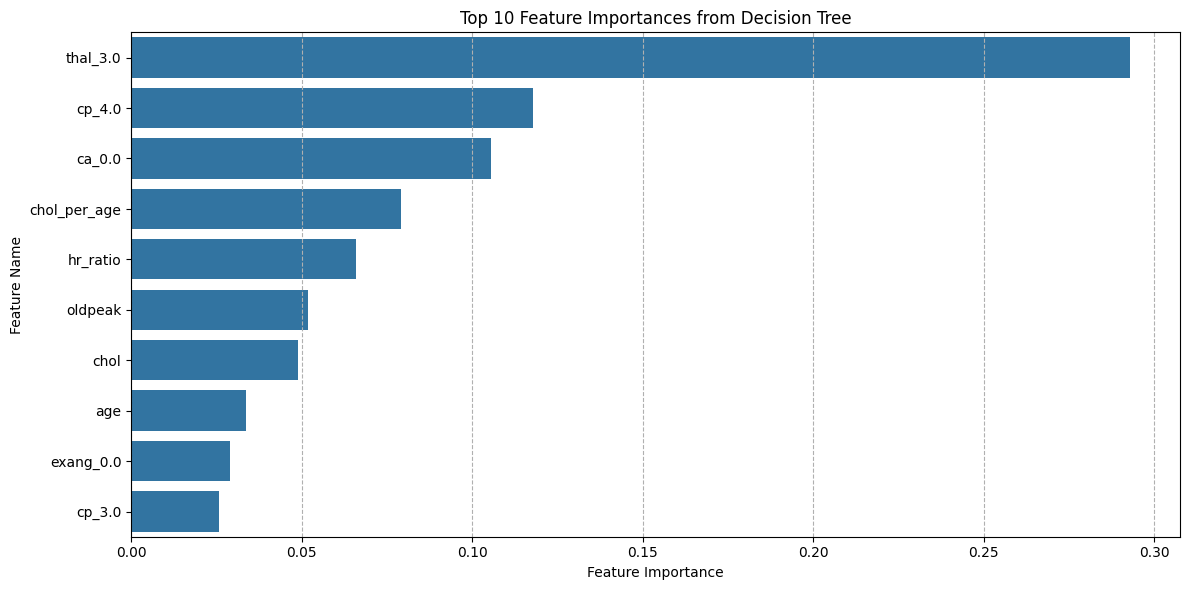
Tiếp theo, để giảm độ phức tạp và tránh hiện tượng quá khớp, nhóm tiến hành lựa chọn đặc trưng bằng mô hình cây quyết định (Decision Tree). Phương pháp này đánh giá mức độ đóng góp của từng đặc trưng trong việc phân chia dữ liệu theo biến mục tiêu.
Kết quả của quá trình đánh giá cho phép xác định đặc trưng có mức độ quan trọng cao nhất. Thực hiện tương tự trên bộ dữ liệu FE trước đó, ta có 2 bộ dữ liệu riêng biệt:- Bộ thứ nhất là bộ gốc sau khi chọn K = 10 đặc trưng, chỉ giữ lại các biến có giá trị đóng góp cao nhất từ dữ liệu gốc đã chuẩn hóa.
- Bộ thứ hai là bộ FE sau khi chọn K = 10 đặc trưng, được xây dựng tương tự nhưng áp dụng trên tập dữ liệu đã mở rộng sau Feature Engineering.
Cân bằng dữ liệu bằng SMOTE
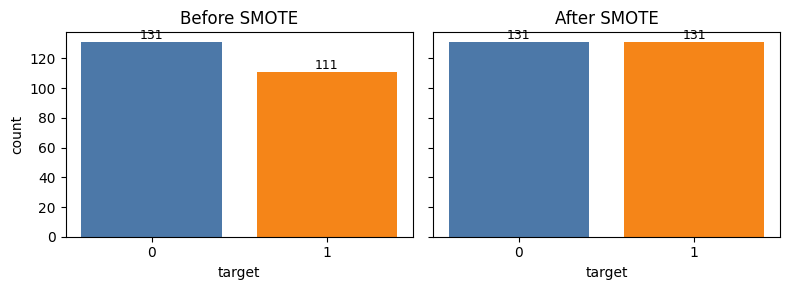
Dữ liệu y khoa thường gặp tình trạng mất cân bằng — số lượng bệnh nhân không mắc bệnh thường nhiều hơn đáng kể so với bệnh nhân mắc bệnh. Để khắc phục điều này, nhóm áp dụng SMOTE (Synthetic Minority Over-sampling Technique) lên bộ dữ liệu đã qua Feature Engineering.
SMOTE hoạt động bằng cách tạo ra các mẫu nhân tạo mới cho lớp thiểu số dựa trên khoảng cách giữa các điểm dữ liệu gần nhau. Cách làm này khác với việc nhân bản dữ liệu cũ; nó tạo ra các điểm mới nằm giữa những mẫu thật, giúp mô hình học máy nhận được phân bố hợp lý hơn.
Kết quả là bộ dữ liệu sau SMOTE có tỷ lệ hai lớp cân bằng hơn, giảm thiểu nguy cơ mô hình bị thiên lệch về nhóm chiếm đa số. Đây là bộ dữ liệu hoàn chỉnh và tối ưu nhất trong toàn bộ quy trình, thường được sử dụng để huấn luyện mô hình cuối cùng.
3. Huấn luyện và tối ưu hoá mô hình với Optuna.
Nhóm tiến hành huấn luyện sáu mô hình học máy gồm AdaBoost (ADB), Random Forest (RF), Gradient Boosting (GB), LightGBM (LGBM), XGBoost (XGB) và CatBoost (CAT) trên năm biến thể của bộ dữ liệu (raw, dt, fe, fe_dt, fe_sm) nhằm đánh giá ảnh hưởng của các bước xử lý đặc trưng đến hiệu suất dự đoán.
Để đạt được cấu hình siêu tham số tối ưu cho từng mô hình, nhóm sử dụng Optuna — một thư viện tối ưu hoá hiện đại dựa trên thuật toán Bayesian Optimization kết hợp với Tree-structured Parzen Estimator (TPE). Phương pháp này giúp tìm kiếm không gian siêu tham số một cách thông minh, tập trung vào các vùng tiềm năng có khả năng mang lại kết quả cao nhất, thay vì duyệt toàn bộ như Grid Search truyền thống.
IV. Kết quả thực nghiệm
Nhóm đánh giá hiệu suất của sáu mô hình học máy — bao gồm AdaBoost (ADB), Random Forest (RF), Gradient Boosting (GB), LightGBM (LGBM), XGBoost (XGB) và CatBoost (CAT) — khi được huấn luyện trên năm biến thể của bộ dữ liệu: raw, dt, fe, fe_dt, và fe_sm. Các giá trị thể hiện độ chính xác trên tập validation và test, được thể hiện trong bảng sau:
| Model / Dataset | raw | dt | fe | fe_dt | fe_sm |
|---|---|---|---|---|---|
| ADB | 0.933 / 0.871 | 0.967 / 0.839 | 0.967 / 0.839 | 0.967 / 0.839 | 0.967 / 0.839 |
| RF | 0.933 / 0.871 | 0.933 / 0.806 | 0.900 / 0.806 | 0.933 / 0.839 | 0.967 / 0.806 |
| GB | 0.900 / 0.806 | 0.933 / 0.839 | 0.933 / 0.871 | 0.933 / 0.806 | 0.967 / 0.806 |
| LGBM | 0.867 / 0.871 | 0.900 / 0.806 | 0.900 / 0.806 | 0.967 / 0.871 | 0.933 / 0.774 |
| XGB | 0.933 / 0.839 | 0.900 / 0.806 | 0.900 / 0.903 | 0.933 / 0.806 | 0.933 / 0.774 |
| CAT | 0.900 / 0.806 | 0.967 / 0.839 | 0.933 / 0.839 | 0.933 / 0.839 | 0.900 / 0.774 |
Nhìn chung, các mô hình đạt độ chính xác cao và ổn định, phần lớn dao động trong khoảng 0.90–0.97 trên cả hai tập đánh giá. Điều này cho thấy quy trình tiền xử lý và lựa chọn đặc trưng đã giúp dữ liệu có chất lượng tốt, hỗ trợ huấn luyện hiệu quả cho hầu hết các thuật toán. Cụ thể:
- AdaBoost (ADB) thể hiện hiệu suất nổi bật và ổn định nhất, đạt kết quả cao nhất ở hầu hết các bộ dữ liệu với giá trị 0.967 trên tập validation, trong khi độ chính xác trên test dao động quanh 0.839.
- Random Forest (RF) cho kết quả khá cạnh tranh, đặc biệt khi áp dụng trên bộ fe_sm, đạt 0.967 trên validation. Tuy nhiên, độ chính xác trên test vẫn thấp hơn một chút so với ADB.
- Gradient Boosting (GB) có xu hướng tương tự RF, với hiệu suất tốt hơn khi dữ liệu được cân bằng hoặc mở rộng (ở fe_sm đạt 0.967).
- LightGBM (LGBM) thể hiện hiệu suất cao nhất trên bộ fe_dt với 0.967 / 0.871, cho thấy việc kết hợp Feature Engineering và lựa chọn đặc trưng bằng Decision Tree giúp LGBM học tốt hơn.
- XGBoost (XGB) có điểm mạnh riêng ở khả năng tổng quát trên test — đặc biệt ở fe, nơi mô hình đạt giá trị cao nhất là 0.903. Điều này cho thấy XGBoost tận dụng tốt các đặc trưng mở rộng được tạo ra từ Feature Engineering.
- CatBoost (CAT) có hiệu suất khá ổn định, nhưng không vượt trội. Kết quả cao nhất của mô hình (0.967 / 0.839 trên dt) chứng tỏ nó hưởng lợi rõ rệt từ dữ liệu được chọn lọc đặc trưng tốt.
V. Tổng kết
Các mô hình ensemble learning đã cho thấy sự hiệu quả trong việc chẩn đoán bệnh tim, đặc biệt khi được kết hợp với các bước xử lý và tối ưu dữ liệu phù hợp. Kết quả thực nghiệm chỉ ra rằng việc feature engineering, lựa chọn đặc trưng bằng Decision Tree, và cân bằng dữ liệu bằng SMOTE có tác động rõ rệt đến hiệu suất mô hình, giúp nâng cao độ chính xác và khả năng tổng quát hóa.
Trong số các mô hình được khảo sát, AdaBoost thể hiện hiệu năng ổn định và cao nhất trên nhiều bộ dữ liệu, trong khi LightGBM và XGBoost cũng cho thấy tiềm năng lớn khi kết hợp với dữ liệu được mở rộng hoặc chọn lọc hợp lý. Việc sử dụng Optuna để tối ưu siêu tham số giúp các mô hình đạt được cấu hình tốt nhất mà không cần tốn quá nhiều công sức thủ công.
Nhìn chung, kết quả nghiên cứu khẳng định rằng hiệu quả của mô hình học máy trong y học không chỉ phụ thuộc vào thuật toán, mà còn phụ thuộc mạnh mẽ vào chất lượng và chiến lược xử lý dữ liệu.
Toàn bộ mã nguồn bọn mình để ở đây nhé